
Faux Googlebot : comment repérer ces robots qui faussent vos statistiques
Un robot qui se présente comme Googlebot n’est pas forcément Googlebot. Le nom qu’il annonce dans sa requête, la chaîne user-agent, peut être falsifié.1 Le changer pour se dire Googlebot tient en une ligne de code.2 Google indique comment vérifier qu’une requête vient réellement de lui. On fait une recherche DNS inverse sur l’adresse IP, puis une recherche directe, ou l’on compare cette adresse à ses listes publiées.3
Gary Illyes, de Google, a parlé de l’identité des robots dans l’Odys Podcast, dans un épisode mis en ligne le 28 octobre 2026.2 L’usurpation de Googlebot pose davantage problème aujourd’hui, et la raison, il pense que c’est l’IA.4
Ce que Gary Illyes a dit le 28 octobre
De plus en plus d’entreprises cherchent des données pour entraîner leurs propres modèles, et il leur faut du contenu. Gary Illyes décrit un Internet vu comme une grande ferme, où l’on va récolter ce dont on a besoin.4 Les pare-feu et les CDN, les réseaux de diffusion de contenu, repèrent de mieux en mieux ces robots. Ils ne sont pas parfaits, et une partie du trafic qu’ils devaient arrêter passe encore.4 Celui qui fait tourner un petit moteur d’IA, ou qui veut aspirer un site, peut se dire Googlebot pour être laissé entrer. Sinon, il risque d’être bloqué.4
Gary Illyes a installé en ligne des sites pièges, des « honeypots », qui attirent les robots. Il y a trouvé des requêtes qui se disaient Googlebot et venaient d’adresses IP sans rapport avec Google.4 Les propos rapportés ne donnent aucune proportion de ces faux robots.4
Un robot mal réglé peut redemander les mêmes adresses sans arrêt. Il consomme la bande passante et les ressources du serveur, et peut empêcher les vrais visiteurs d’accéder au site. Pour Gary Illyes, une bonne part des dégâts actuels vient de l’ignorance ou d’une mauvaise mise en œuvre, plutôt que d’attaques délibérées.4
Ce que les faux Googlebot faussent, et ce qu’ils épargnent
Quand un robot demande une page, il annonce un nom, ChatGPT-User, Claude-User ou Googlebot. Le serveur écrit ce nom dans son journal, l’outil d’analyse le compte, et l’on en tire des conclusions. Ce nom est déclaré par le robot lui-même, ce n’est qu’une chaîne de caractères dans l’en-tête de la requête.5
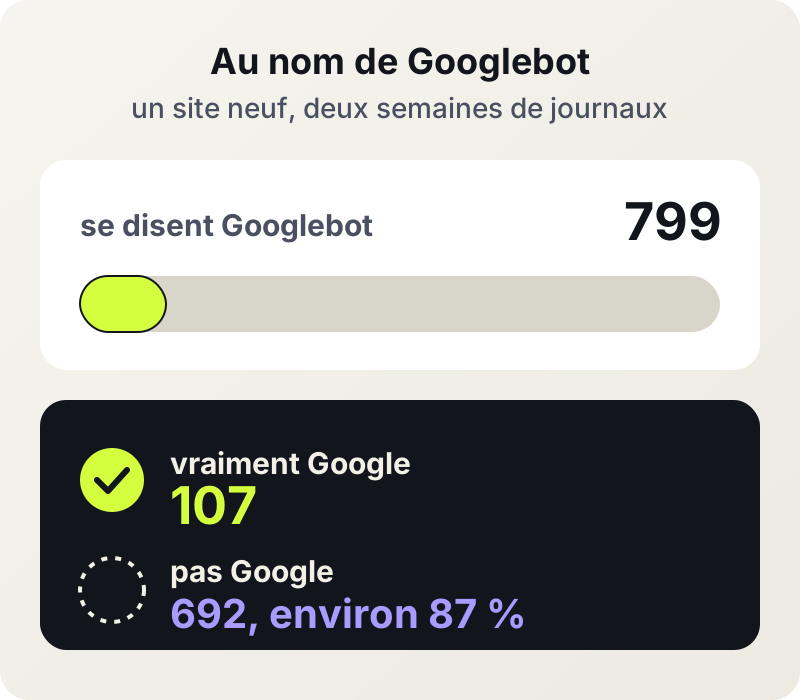
Duane Forrester, fondateur du cabinet de conseil UnboundAnswers, a vérifié deux semaines de journaux d’un site qu’il venait de lancer. Sur 799 requêtes au nom de Googlebot, 107 seulement venaient d’une adresse vérifiée de Google. Les 692 autres, environ 87 %, n’étaient pas Google.5 Certains faux robots portaient le nom d’un assistant d’IA et réclamaient au serveur ses fichiers secrets, comme .env.production ou config.json.5 Il présente ces chiffres comme le relevé d’un seul petit site, et non comme une mesure du Web.5
Pour les visiteurs humains, Duane Forrester s’en remet à Google Analytics 4, et il lit ses journaux pour les robots.5 Google Analytics exclut en effet automatiquement le trafic des robots connus. On ne peut pas désactiver cette exclusion, ni connaître le volume de trafic écarté.6 Ces robots sont repérés à partir des données de la recherche Google et de la liste internationale de l’Interactive Advertising Bureau, l’IAB.6
Les vrais passages de Google se lisent aussi dans le rapport « Statistiques sur l’exploration » de la Search Console, l’outil gratuit de Google pour les propriétaires de sites. Toutes les adresses qu’il compte sont celles demandées par Google.7 Le rapport ne compte pas encore toutes les demandes, et de légères différences peuvent apparaître avec les journaux du site. Pour un site de moins de 1 000 pages, ce rapport ne sera probablement d’aucune utilité.7
La vérification de Google, en quatre étapes
La vérification vaut pour Googlebot et pour les autres robots de Google. Elle sert quand on soupçonne des spammeurs ou d’autres personnes mal intentionnées d’accéder au site en se faisant passer pour Google. Pour une recherche ponctuelle, Google indique les outils en ligne de commande, une méthode suffisante dans la plupart des cas.3
- Lancer une recherche DNS inverse, avec la commande host, sur l’adresse IP relevée dans les journaux.
- Vérifier que le nom de domaine obtenu est googlebot.com, google.com ou googleusercontent.com.
- Lancer une recherche DNS directe sur ce nom de domaine, toujours avec la commande host.
- Vérifier qu’elle redonne la même adresse IP que celle des journaux.
Dans l’exemple de Google, l’adresse 66.249.66.1 renvoie au nom crawl-66-249-66-1.googlebot.com. Ce nom renvoie à son tour à l’adresse 66.249.66.1.3

Cette requête vient-elle vraiment de Google ?
Recopiez les trois valeurs, le verdict se met à jour aussitôt. Rien n'est envoyé, le contrôle se fait dans votre navigateur.
Comment le contrôle est fait
Les deux règles viennent de la page de Google sur la validation des requêtes de ses robots, relue le 2 novembre 2026. Le nom de l'étape 2 doit appartenir au domaine googlebot.com, google.com ou googleusercontent.com, et l'adresse de l'étape 3 doit être la même que celle de l'étape 1. Les recherches DNS se font avec la commande host. L'exemple fictif utilise une adresse réservée à la documentation, 203.0.113.45.
Les listes d’adresses publiées par Google
Pour des recherches plus larges, Google conseille une solution automatique. Elle compare l’adresse IP du robot à la liste des adresses publiées par Google. Ses robots se rangent en trois catégories, chacune avec ses noms d’hôte et ses fichiers d’adresses. Les adresses de ces fichiers JSON sont écrites au format CIDR, une notation par plages.3
| Catégorie | Nom donné par le DNS inverse | Fichier d’adresses |
|---|---|---|
| Robots communs, comme Googlebot | crawl-…googlebot.com ou geo-crawl-…geo.googlebot.com3 | common-crawlers.json3 |
| Robots spéciaux, comme AdsBot | rate-limited-proxy-…google.com3 | special-crawlers.json3 |
| Extracteurs déclenchés par un utilisateur | …gae.googleusercontent.com ou google-proxy-…google.com3 | user-triggered-fetchers.json, user-triggered-fetchers-google.json et user-triggered-agents.json3 |
Les robots communs, comme Googlebot, respectent toujours les règles du fichier robots.txt lors de l’exploration automatique.1 Les extracteurs déclenchés par un utilisateur, comme Google Site Verifier, ignorent ces règles, puisque c’est une personne qui a demandé l’exploration.3
Duane Forrester applique la même méthode aux robots d’IA. OpenAI, Anthropic, Perplexity et Common Crawl publient aussi les adresses de leurs robots, en fichiers que l’on peut ouvrir. Une requête n’est légitime que si le nom correspond et que l’adresse figure dans la liste publiée. Le nom est la déclaration, l’adresse est la preuve.5 Il range chaque requête en trois cas, vérifiée, usurpée, ou invérifiable quand une liste ne se charge pas ou qu’un enregistrement manque.5
Web Bot Auth et réputation, ce que Google prépare
Google teste Web Bot Auth, un projet de l’IETF, l’organisme qui élabore les normes techniques d’Internet. C’est un nouveau protocole cryptographique, qui permet aux sites de vérifier qu’un robot est authentique. Google le teste avec certains agents d’IA hébergés sur son infrastructure.8 Au lieu de s’en remettre aux seuls en-têtes déclarés et aux adresses IP, les agents signent leurs requêtes.8
Ce protocole est expérimental. Tous les robots de Google ne l’utilisent pas, et Google ne signe pas encore toutes les requêtes des agents qui l’emploient. Google recommande de continuer à s’appuyer sur les adresses IP, le DNS inverse et le nom du robot, en plus de Web Bot Auth.8 Les requêtes signées de l’agent Google-Agent sont authentifiées sous le nom https://agent.bot.goog.8
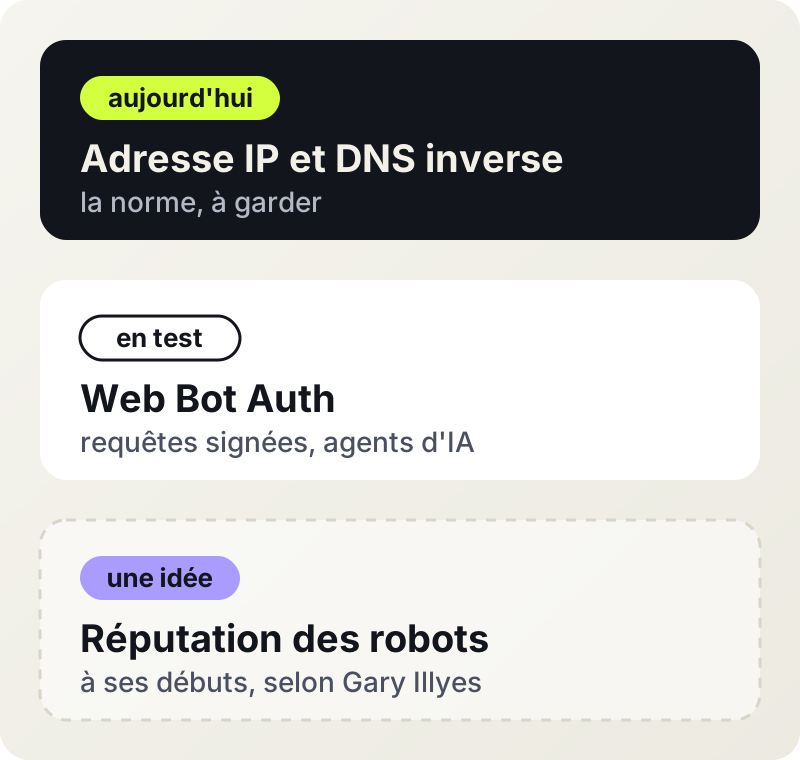
Pour Gary Illyes, ces signatures évitent de dépendre des seules adresses IP, qui deviennent plus difficiles et plus coûteuses à gérer.4 Il explore aussi l’idée d’un système de réputation des robots, avec ceux qui travaillent sur le robots.txt, mais elle n’en est qu’au tout début. Un tel système pourrait réunir l’avis des sites et des services de sécurité sur la conduite des robots. Il prévient qu’un système tenu par une seule entreprise risquerait d’être biaisé.4
Ce que font les sites, petits ou grands
Le fichier robots.txt est une suggestion, et non une restriction. Les robots légitimes le respectent en général, mais un robot peut l’ignorer. Pour bloquer un trafic indésirable, il faut une protection au niveau du réseau, comme un pare-feu applicatif, le WAF.4
La plupart des petits sites n’ont pas besoin de s’inquiéter tout de suite. Gary Illyes conseille de vérifier d’abord si le trafic des robots pose vraiment un problème, avant d’investir dans une protection. Pour un site qui a besoin d’aide, un CDN qui gère les robots est un bon point de départ, et des plates-formes hébergées comme Shopify protègent déjà leurs sites.4 Les principaux CDN, pare-feu applicatifs et services de détection des robots sont compatibles avec Web Bot Auth.8
Duane Forrester propose de faire le même contrôle sur ses propres journaux. On prend une période, on relève les noms des robots, et l’on vérifie leurs adresses dans les listes publiées.5
Le jeton Google-Extended du fichier robots.txt laisse Googlebot explorer les pages pour la recherche. Il limite en même temps certains usages du contenu pour entraîner des modèles d’IA de Google.4 Ce jeton n’explore rien lui-même. Une requête qui se présente sous le nom de Google-Extended est donc fausse, sans même vérifier son adresse.5
Questions fréquentes
Comment savoir si un Googlebot est faux ?
Pour savoir si un Googlebot est faux, on ne se fie pas au nom du robot, qui se falsifie facilement. On lance une recherche DNS inverse sur l'adresse IP relevée dans les journaux du serveur, on vérifie que le nom obtenu appartient à googlebot.com, google.com ou googleusercontent.com, puis on lance une recherche DNS directe sur ce nom. Si elle redonne la même adresse, la requête vient de Google. Sinon, c'est un faux. On peut aussi comparer l'adresse aux listes publiées par Google.
Les faux Googlebot faussent-ils Google Analytics ?
Les faux Googlebot faussent surtout les journaux du serveur et les outils qui s'en servent, qui comptent chaque requête sous le nom que le robot se donne. Google Analytics exclut automatiquement le trafic des robots connus, repérés grâce aux données de la recherche Google et à la liste internationale de l'IAB. Cette exclusion ne peut pas être désactivée, et Google Analytics ne dit pas combien de trafic il a écarté.
Pourquoi des robots se font-ils passer pour Googlebot ?
Des robots se font passer pour Googlebot pour être laissés entrer sur des sites qui les bloqueraient autrement. Changer le nom annoncé par un robot tient en une ligne de code. Pour Gary Illyes, de Google, le problème s'est aggravé avec l'IA, parce que de plus en plus d'entreprises cherchent du contenu pour entraîner leurs propres modèles.
Où trouver les adresses IP de Googlebot ?
Google publie les adresses IP de ses robots dans des fichiers JSON, au format CIDR. Les robots communs comme Googlebot sont dans common-crawlers.json, les robots spéciaux comme AdsBot dans special-crawlers.json, et les extracteurs déclenchés par un utilisateur dans user-triggered-fetchers.json, user-triggered-fetchers-google.json et user-triggered-agents.json. Pour les autres adresses de Google, on se reporte à sa liste générale.
Qu'est-ce que Web Bot Auth ?
Web Bot Auth est un protocole cryptographique expérimental, en cours d'élaboration à l'IETF, qui permet à un site de vérifier qu'un robot est bien celui qu'il prétend être. Au lieu de se fier au nom déclaré et à l'adresse IP, l'agent signe ses requêtes. Google le teste avec certains agents d'IA hébergés sur son infrastructure, sans signer toutes leurs requêtes, et recommande de garder la vérification par adresse IP et DNS inverse.
Le fichier robots.txt bloque-t-il les faux Googlebot ?
Non, le fichier robots.txt ne bloque pas les faux Googlebot. Gary Illyes, de Google, le décrit comme une suggestion et non comme une restriction. Les robots légitimes le respectent en général, mais un robot peut l'ignorer. Pour bloquer un trafic indésirable, il faut une protection au niveau du réseau, comme un pare-feu applicatif.
Combien de faux Googlebot visitent un site ?
Il n'existe pas de chiffre général, et Google n'en publie pas. Sur deux semaines de journaux d'un site neuf, le consultant Duane Forrester a compté 799 requêtes au nom de Googlebot, dont 107 venaient d'une adresse vérifiée de Google. Les 692 autres, environ 87 %, n'étaient pas Google. C'est le relevé d'un seul petit site, pas une mesure du Web.
Nos sources
- Robots d'exploration communs de GoogleGoogle, infrastructure d'exploration, consulté le 2 novembre 2026
- Anyone Can Fake Googlebot in 30 Seconds | Gary Illyes, GoogleOdys Podcast, Aneta Samkoff, avec Gary Illyes (Google), 28 octobre 2026
- Validation des requêtes des robots d'exploration et des extracteurs GoogleGoogle, infrastructure d'exploration, mis à jour le 25 mars 2026
- Google's Gary Illyes: AI Made Bot Impersonation WorseSearch Engine Roundtable, Barry Schwartz, 30 octobre 2026
- 81.8% Of My 'AI Assistant' Traffic Was Fake. The Googlebot Number Was WorseSearch Engine Journal, Duane Forrester (UnboundAnswers), 25 juin 2026
- Exclusion du trafic généré par des robots connusAide Google Analytics, consulté le 2 novembre 2026
- Rapport « Statistiques sur l'exploration »Aide Search Console, consulté le 2 novembre 2026
- Authentifier des requêtes avec Web Bot Auth (état expérimental)Google, infrastructure d'exploration, mis à jour le 19 octobre 2026
Une erreur, une règle qui a changé ? Signalez-la, nous corrigeons et datons la correction.